MiniMax 正式发布 H3-Image,并同步开放模型权重,现在我感觉它开源的很多模型其实都挺不错的。与以往很多生图模型强调画质不同,这次 MiniMax 明显希望解决一个实际问题:能否让高质量图片生成变得足够快、足够便宜,从而真正进入高频生产流程?
H3-Image 到底有什么亮点?其实总结起来就三个
第一,原生生成约 1600 万像素,而不只是把低分辨率图片放大。H3-Image 支持 4096×4096 的方图,也支持 6272×2688 的宽幅图像。官方模型卡明确说明,不依赖额外的超分模型完成这些分辨率的输出。这意味着模型能够直接在高分辨率生成过程中建模细节,而不仅是在最后阶段进行插值放大。不过,像素数量更高不等于所有语义细节都必然准确。按照官方公布的对比数据,4K 文生图标准模式的中位耗时约 16 秒,Highspeed 模式约 10.3 秒。也就是说,宣传中的“10 秒以内”更接近理想化表述,实际耗时仍受生成模式、硬件和服务负载影响。但即使是 10~20 秒,在高分辨率图片生成上依然很有竞争力。
第三,最多支持 16 张参考图,让模型不再局限于简单的文生图。例如,提供人物、服装、背景、构图等不同参考图,再让模型组合成新画面。这种能力更适合实际设计工作,因为专业创作者往往不是从零生成,而是基于现有素材持续修改。从模型架构上来看,H3-Image 采用了约 33.1B 参数的 Diffusion Transformer(DiT)。它继承了 H3 的架构,移除了音频分支,并使用 Qwen3-VL 相关文本编码器进行条件理解。其图像 VAE 使用 16 倍空间下采样,DiT 对潜变量再进行 2×2 patch 划分。其中,最重要的技术点是:模型经过蒸馏后,仅需 6 次函数评估(6 NFEs),且不需要 Classifier-Free Guidance。
对于扩散模型而言,减少采样步数能够直接降低重复执行 Transformer 的成本。当生成分辨率提高时,这种优化的价值尤其突出。不过,H3-Image 仍然是大模型。其公开 BF16 图像模型文件约 68.65GB,文本编码器还需额外加载,并不是普通消费级显卡就能轻松达到官方宣传速度的模型。具体效果怎么样?
01 工程制图与复杂指令 —— 生图模型的「老牌翻车现场」
CAD 蓝图、爆炸拆解图、空间 HUD 是最容易翻车的题型:字不能错、零件不能装反、框要贴着透视走。这一组考的不是画功,是「脑子」。A1 埃菲尔铁塔 → 赛博朋克星际通信中继站(CAD 蓝图)
把巴黎埃菲尔铁塔改造成赛博朋克世界里的未来星际通信中继站,且必须以专业建筑 CAD 蓝图呈现——超精细矢量线条、严格对称结构、复杂剖面与密密麻麻的工程细节一样不能少。结果超出测试者预期:正视图、剖面、放大节点一应俱全,指令遵循能力可见一斑。 A2 应县木塔营建蓝图
中国古建同样成立:为应县木塔生成「真正营建用的蓝图」,对称剖面与标注体系按工程语言呈现,而不是画一张风景画。 A3 四足机器狗 · 地震废墟第一视角感知 HUD
该图片疑似使用了AI生成技术,请谨慎甄别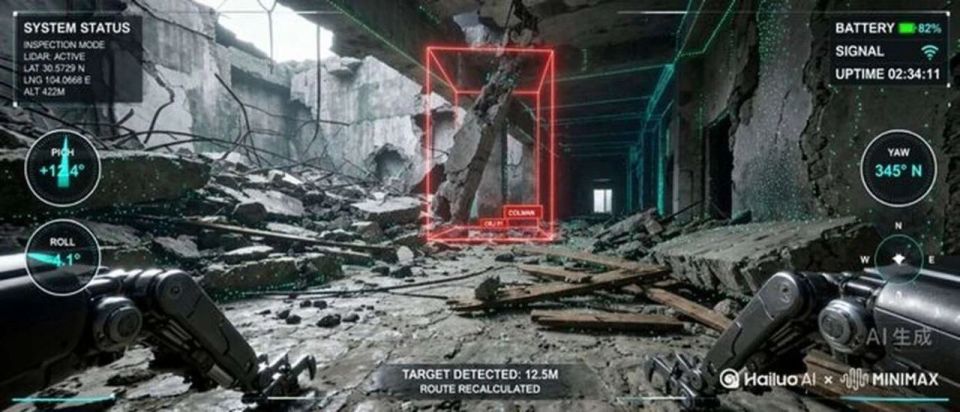
要求前景有机械足部边缘透视、中景坍塌残骸,叠加三维点云测距网格,远处指定梁柱周围绘制贴合透视的红色 3D 边界框,两侧带对称姿态仪。难点不在「框」,而在框顺着透视贴在障碍物边缘、姿态仪刻度与机体前倾姿态对齐——模型像先在脑内搭了三维空间再往里摆东西。工业辅助设计与具身智能合成数据的用武之地。 A4 ORB-7 微型探照灯 · 看图纸拆成七件
喂给模型的只有一页 ORB-7 结构参考:正面图、中心剖面和一份零件清单,全是平面工程语言;要求沿光轴拆成七件、顺序不能错、螺钉只能有三枚。结果 01–07 引线一根没错,螺钉与孔位是三个;拉丝铝、玻璃、橙色硅胶、绿色电路板、阳极氧化金属各是各的质感,连藏在清单小字里的方形金色芯片、散热槽也画了出来。它先「看懂」了剖面图,再动手拆。 A5 未来主义咖啡机 · 产品爆炸图
展示豆仓、研磨器、冲煮模块、水箱等结构,标明各部分连接关系并保持产品设计一致性。考验的是模型能否理解「零件如何组装」这类真实设计需求,而不是只会摆漂亮的物体。 A6 社区玩法 · CAD 风格图与机械爆炸图
Ankit Patel、studio_oneroom 等创作者让它出 CAD 风格图与「零件一颗颗拆开悬在半空」的机械爆炸图——正是这类高难需求在社区刷屏,把「指令遵循」变成了这款模型最出圈的标签。 A7 美国手语手势 · 48.1% vs Moss 的 20%
手语是 AI 模型几乎都会画错的场景(U/V 互换、格子标错)。据社区统计,H3 Image 正确率 48.1%,几乎是 Moss(20.0%)的两倍半。极细粒度的语义-动作对应,是「指令遵循」的硬指标。 A8 大字海报 · 大字稳、小字大体对
博主 plasm0 的结论:大字很稳,小字偶尔出错、但大体是对的。对海报、封面、招牌这类「必须把字写对」的场景,是从 0 到 1 的可用性跨越。 02 游戏美术与 3A 资产 —— 一次生成「能玩的画面」
游戏实机感是美学与指令遵循的双重考验:UI 不能糊进背景、主角不能崩、要像玩家随手截的一帧,而不是官方宣传图。B1 次世代暗黑奇幻动作游戏 · 实机界面截图
该图片疑似使用了AI生成技术,请谨慎甄别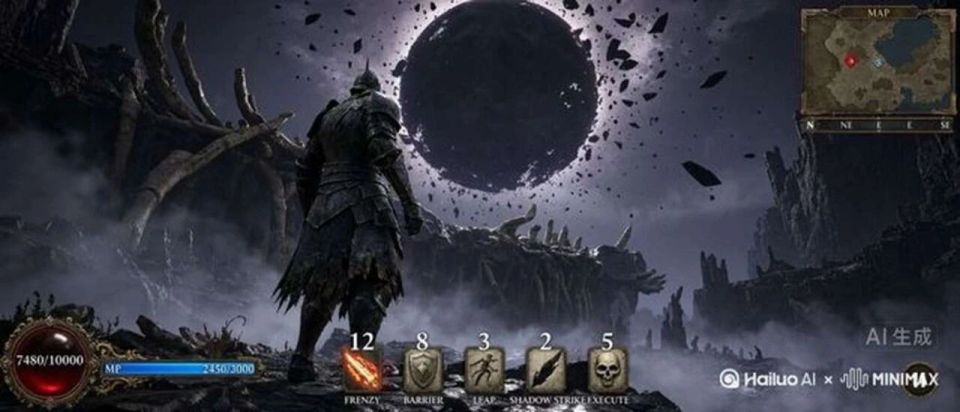
提示词要求的元素一样不少:身披残破重甲的骑士立于骨骸废墟悬崖、远方崩解的「黑日」带体积雾与光追反射;前景完整 UI——巴洛克金属雕花环绕的暗红血球与蓝色法力槽、底端五个带冷却倒计时的石雕符文技能图标、右上角羊皮纸风格小地图。「游戏场景+整套 UI」常见的两种死法(UI 糊进背景 / UI 在了主角崩了)它都躲开了。 B2 《GTA:圣安地列斯》老截图 → 次世代重画
博主 Papillon 翻出 20 年前的老截图让模型重画成 3A 大作,配文「CJ 等了 20 年的画质升级,到货了」。对老游戏画面的理解与重绘,直接验证了它对「游戏画面感」的把握。 B3 GTA V 实机画面感复刻
提示词里指定风格与第三人称视角。它的理解是「GTA 游戏画面感」而非「GTA 风格」——出图像是玩家随手截的一帧,而不是精心摆拍的宣传图。 B4 生存游戏界面 · 文字渲染与布局
界面里要正确渲染并布局生命、魔力、体力等级等数值文字,同时维持生存游戏的视觉语言——文字渲染与游戏 UI 的组合题,一次通过。 B5 3A 游戏资产与 3D 场景
喊出「GPT is cooked」的博主 Israa Ali 测的是 3A 游戏资产与 3D 场景:材质、光影与构图都向「可直接进管线的概念资产」靠拢。游戏美术是 H3-Image 社区实测里最集中的方向。 )B6 一张照片 → 整套 4K 角色设定图
博主 Muhammad Ayan 的结论是「AI 人像那层塑料皮,没了」:一张照片进去,产出全套设定图——全身正面、背面、脸部特写,毛孔、雀斑、细绒毛都在。角色设定与多视图一致性一步到位。 03 文字渲染与信息图 —— 把字写对,还要排版好看
「既要把字写对,又要兼顾字体设计、画面构图和整体视觉效果」——大字海报、大段小字、中英混排,这一节全是生图模型的传统噩梦区。C1 PHOENIX MYTH · 新古典主义装饰艺术海报
融合西方神话、复古雕版画、维多利亚纹样与现代极简排版。标题 PHOENIX MYTH 与副标题 Eternal Rebirth of the Fire Bird 全部准确渲染——大字标题准确率接近「可用即所得」。 C2 黄仁勋公开信 · 信纸版重排
小字极限测试:把沸沸扬扬的黄仁勋公开信生成一份放在桌面的信纸版。大段小字基本全部准确、无明显错字,信纸周围细节还藏着与老黄相关的彩蛋。信息层级、排版与文字准确性的三重考验。 C3 中文书法海报 ·「共赴山野,画地为牢」
以悬崖小屋照片为参考图生成的旅游海报:草坡、云海、玻璃小屋保真,中文书法标题两行同等大小排版(第一版大小失衡,调整提示词后即修正)。4K 输出下连右下角小字「后会有期,山顶见」也清晰可读。实测 Prompt 摘录:参考照片中的长条玻璃小屋,保留主要外形和草坡环境,重新设计为立体纸雕旅行海报……「共赴山野」和「画地为牢」以同等大小组成完整的两行标题,底部小字「后会有期,山顶见」。
C4 挂在墙上的经典皮衣 ·「我已经被穿了 30 年了。」
怀旧场景 + 叙事文字的组合:墙上经典皮衣、打字机上的独白文字与画面气质互相成就。文字不只是「渲染正确」,还要成为画面情绪的一部分。 04 写实人像与摄影美学 —— 去掉那层「AI 塑料皮」
官方强调「摆脱 AI 图过度平滑的人工感」。实测里最打动人的正是摄影质感:慢门拖影、直闪胶片、自然皮肤纹理。D1 赛马 · 电影感慢门追焦摄影
提示词明确核心风格:电影感动态摄影、慢门追焦、复古运动胶片美学。赛马高速奔跑的横向拖影、深墨绿背景、金色夕阳照亮的马匹、大面积幽暗的负空间全部到位——「不但没有 AI 味,甚至有强电影感」。 D2 速度系列 · 赛车 / 骑行 / 滑板 / 奔跑
用同一组提示词迁移到不同运动场景:运动主体逐渐消融成光线、色彩与时间的痕迹,呈现摄影中那种「不完美但动人」的质感——风格指令的跨题材一致性。 D3 复古直闪胶片人像
复古直闪胶片摄影 + 生活方式纪实 + 独立时尚杂志美学。画面像朋友在私人派对上随手拍的瞬间,皮肤保留自然纹理、无过度磨皮与油腻感——这正是「AI 人像塑料皮」被拿掉的地方。 D4 东方古典美学电影剧照
中国古装电影摄影 + 自然主义光影 + 复古胶片质感:穿过树叶的午后阳光照亮脸庞,自然神情与斑驳树影,让画面像「被时间珍藏的电影记忆」。05 艺术风格与手工质感 —— 没有 AI 图那股「油腻的数码味」
定格动画的毛边、水彩沉在粗纹纸上的水痕——材质层面的真实感,是「画质」叙事之外最容易被忽略、也最难造假的部分。G1 毛毡定格动画 · 两只穿粗毛线衣的小羊
该图片疑似使用了AI生成技术,请谨慎甄别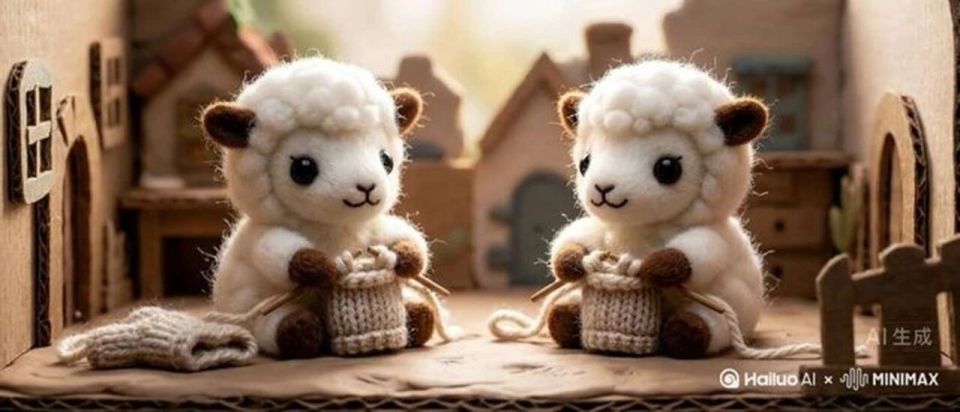
逆光里绒毛透着亮,黏土底座上的指纹、纸板切口的毛边都在。这些「不完美」的细节让图像看起来像真实的定格动画道具,而非渲染出来的替代品。 G2 钢笔淡彩 · 下笔轻重与纸上水痕
「下笔的轻重、水彩沉在粗纹纸上的水痕都有,没有 AI 图那股油腻的数码味。」传统绘画媒介的模拟精度,直接决定了插画类商用的可用度。我的总体评价
H3-Image 最值得肯定的,是 MiniMax 没有单纯追求更大的模型和更高的分辨率,而是把生成质量、采样效率、推理系统和开放生态组合成了一个相对完整的产品。当然,它距离全面替代顶尖闭源模型还有距离,尤其是高精度编辑、文字排版、跨图一致性以及生产级可靠性等方面,仍然需要独立评测。但如果后续社区能够进一步完成量化、轻量化和推理加速,那么 H3-Image 的长期价值很可能不只是一个“10 秒出 4K”的模型,而是成为开源图像生成生态中的重要基础模型。 【版权声明】本文内容来源于算法一只狗,版权归原作者及原媒体所有。本站仅作信息分享,不构成任何商业用途;如涉版权问题,请联系本站删除。
发布时间:2026-11-14 21:34:12